Simuler le pair trade KO-PEP avec un processus OU, partie I
Je voulais une simulation simple du pair trade classique entre KO et PEP. Le modèle a deux tâches. Il doit conserver la corrélation entre les rendements des actions et ramener l’écart vers sa moyenne.
Données
Récupérer les données
J’ai récupéré 45 ans de cours de clôture ajustés pour KO et PEP depuis Yahoo Finance. Cet historique réduit le poids d’un seul régime de marché de courte durée dans l’estimation des paramètres.
import yfinance as yf
import pandas as pd

tickers = ["KO", "PEP"]
start_date = "1980-01-01"
end_date = "2025-10-01"

# Download historical price data
ko_data = yf.download(
    "KO", start=start_date, end=end_date, auto_adjust=False, progress=False
)
pep_data = yf.download(
    "PEP", start=start_date, end=end_date, auto_adjust=False, progress=False
)

# Extract and align on common dates
ko_adj = ko_data["Adj Close"]
pep_adj = pep_data["Adj Close"]
combined_data = pd.concat([ko_adj, pep_adj], axis=1).dropna().sort_index()
Cours historiques

Paramètres de calibrage
Pour le calibrage, j’ai utilisé les 5 000 derniers jours de bourse, soit environ 20 ans, se terminant à la date du trade du 9 octobre 2023 :
# Calculate daily returns
ko_returns = historical_data["KO"].pct_change().dropna()
pep_returns = historical_data["PEP"].pct_change().dropna()

# Compute statistics for GBM calibration
ko_mean, ko_std = ko_returns.mean(), ko_returns.std()
pep_mean, pep_std = pep_returns.mean(), pep_returns.std()
correlation = ko_returns.corr(pep_returns)
Résultats :
| Paramètre | KO | PEP |
|---|---|---|
| Rendement moyen quotidien | 0.000351 (8.84%/an) | 0.000413 (10.40%/an) |
| Volatilité quotidienne | 0.011552 (18.34%/an) | 0.011264 (17.88%/an) |
| Corrélation | 0.6890 |
Estimer le ratio de couverture
Pour construire un portefeuille neutre au marché, j’ai estimé le ratio de couverture avec une régression linéaire :
$$\text{KO}_t = \alpha + \beta \cdot \text{PEP}_t + \epsilon_t$$# OLS regression: KO = alpha + beta * PEP
X = historical_data["PEP"].values
y = historical_data["KO"].values
beta, alpha = np.polyfit(X, y, 1)
# Calculate goodness of fit
y_pred = beta * X + alpha
r_squared = 1 - (np.sum((y - y_pred) ** 2) / np.sum((y - y.mean()) ** 2))
Résultats de la régression :
- $\beta = 0.3330$ (ratio de couverture)
- $\alpha = 4.6307$
- $R^2 = 0.9604$
En termes de dollars, chaque $1 de PEP est couvert par environ $0.333 de KO.
L’écart et le retour à la moyenne
Définition de l’écart
L’écart est la relation résiduelle de prix entre les deux actions :
$$S_t = \text{KO}_t - \beta \cdot \text{PEP}_t$$où $\beta = 0.333$ est mon ratio de couverture.
# Define spread as hedged portfolio
spread = historical_data["KO"] - beta * historical_data["PEP"]
spread_mean = spread.mean()
spread_std = spread.std()
Résultats :
- $\mu_S$ = 4.6307
- $\sigma_S$ = 2.7545
Modéliser le retour à la moyenne avec Ornstein-Uhlenbeck
Les cours individuels peuvent dériver pendant de longues périodes tandis que l’écart revient vers sa moyenne. Je modélise cette relation avec un processus d’Ornstein-Uhlenbeck, abrégé O-U.
$$dS_t = \kappa(\mu - S_t)dt + \sigma_S dW_t$$où :
- $\kappa$ = vitesse de retour à la moyenne
- $\mu$ = moyenne de long terme de l’écart (4.6307)
- $\sigma_S$ = volatilité de l’écart
- $W_t$ = mouvement brownien
Calibrage de la vitesse de retour à la moyenne :
# Calibrate mean reversion speed
half_life_days = 10
kappa = np.log(2) / half_life_days
Une demi-vie de 10 jours signifie que l’écart est censé refermer la moitié de la distance jusqu’à sa moyenne en 10 jours de bourse.
- $\kappa = 0.0693$
Volatilité de l’écart pour le processus O-U :
$$\sigma_S = \sigma_{\text{empirical}} \cdot \sqrt{2\kappa}$$# O-U diffusion coefficient
spread_volatility = spread_std * np.sqrt(2 * kappa)
- $\sigma_S = 1.0265$
Simulation de Monte Carlo
La simulation combine deux modèles. Un mouvement brownien géométrique corrélé, abrégé GBM, détermine les cours des actions. Un terme d’Ornstein-Uhlenbeck ramène l’écart vers sa moyenne.
Mouvement brownien géométrique pour chaque action
Chaque cours d’action suit un mouvement brownien géométrique :
$$dP_i(t) = \mu_i P_i(t) \, dt + \sigma_i P_i(t) \, dZ_i(t)$$où :
- $P_i(t)$ = prix de l’action au temps $t$ (KO ou PEP)
- $\mu_i$ = dérive (rendement espéré) : $\mu_{KO} = 0.000351$, $\mu_{PEP} = 0.000413$
- $\sigma_i$ = volatilité : $\sigma_{KO} = 0.011552$, $\sigma_{PEP} = 0.011264$
- $dZ_i(t)$ = processus de Wiener (mouvement brownien)
Forme en temps discret (discrétisation d’Euler-Maruyama) :
$$P_{i,t+1} = P_{i,t} \exp\left[\left(\mu_i - \frac{\sigma_i^2}{2}\right)\Delta t + \sigma_i \sqrt{\Delta t} \, \epsilon_i\right]$$où $\epsilon_i \sim \mathcal{N}(0, 1)$ et $\Delta t = 1$ jour.
Corréler les chocs avec une décomposition de Cholesky
Pour générer des chocs de prix corrélés ($\rho = 0.6888$), j’applique une décomposition de Cholesky :
Matrice de corrélation :
$$\mathbf{C} = \begin{bmatrix} 1 & \rho \\ \rho & 1 \end{bmatrix} = \begin{bmatrix} 1 & 0.6888 \\ 0.6888 & 1 \end{bmatrix}$$Facteur de Cholesky (L) :
$$\mathbf{C} = \mathbf{L} \mathbf{L}^T$$# Build correlation matrix
corr_matrix = np.array([[1.0, correlation], [correlation, 1.0]])
cholesky = np.linalg.cholesky(corr_matrix)
Écrite explicitement, la matrice de Cholesky est :
$$\mathbf{L} = \begin{bmatrix} 1.000 & 0.000 \\ 0.689 & 0.725 \end{bmatrix}$$Génération des chocs corrélés :
# Generate independent shocks
z = np.random.standard_normal((n_paths, 2))
# Apply Cholesky transformation
corr_z = z @ cholesky.T
Après cette étape, corr_z[:, 0] et corr_z[:, 1] sont les chocs corrélés de KO et PEP avec $\rho = 0.6890$.
Comment fonctionne la transformation :
$$\begin{bmatrix} \epsilon_{\text{KO}} \\ \epsilon_{\text{PEP}} \end{bmatrix} = \begin{bmatrix} 1.000 & 0.000 \\ 0.689 & 0.725 \end{bmatrix} \begin{bmatrix} z_1 \\ z_2 \end{bmatrix}$$Ce qui donne :
- $\epsilon_{\text{KO}} = 1.000 \cdot z_1 + 0.000 \cdot z_2 = z_1$
- $\epsilon_{\text{PEP}} = 0.689 \cdot z_1 + 0.725 \cdot z_2$
La composante partagée $z_1$ crée la corrélation.
Justification mathématique :
Si $\mathbf{z} = [z_1, z_2]^T$ avec $z_i \sim \mathcal{N}(0, 1)$ i.i.d., alors :
$$\boldsymbol{\epsilon} = \mathbf{L} \mathbf{z}$$a pour matrice de covariance :
$$\mathbb{E}[\boldsymbol{\epsilon} \boldsymbol{\epsilon}^T] = \mathbf{L} \mathbb{E}[\mathbf{z} \mathbf{z}^T] \mathbf{L}^T = \mathbf{L} \mathbf{I} \mathbf{L}^T = \mathbf{C}$$Vérification :
$$\text{Corr}(\epsilon_{\text{KO}}, \epsilon_{\text{PEP}}) = \frac{\text{Cov}(z_1, 0.689 z_1 + 0.725 z_2)}{\sigma_{\epsilon_{\text{KO}}} \cdot \sigma_{\epsilon_{\text{PEP}}}}$$$$= \frac{0.689 \cdot \text{Var}(z_1)}{1 \cdot \sqrt{0.689^2 + 0.725^2}} = \frac{0.689}{1.000} = 0.689 \,\checkmark$$Appliquer le processus O-U à l’écart
Je modélise l’écart lui-même comme un processus de retour à la moyenne :
$$S_t = \text{KO}_t - \beta \cdot \text{PEP}_t$$$$dS_t = \kappa(\mu - S_t) \, dt + \sigma_S \, dW_t$$où :
- $\kappa = 0.0693$ = vitesse de retour à la moyenne (demi-vie de 10 jours)
- $\mu = 4.6307$ = moyenne de long terme de l’écart
- $\sigma_S = 1.0265$ = volatilité de l’écart
- $dW_t$ = mouvement brownien indépendant (non corrélé aux chocs des actions)
Forme en temps discret :
$$\text{O-U adjustment} = \kappa(\mu - S_t) \Delta t + \sigma_S \sqrt{\Delta t} \, \epsilon_3$$où $\epsilon_3 \sim \mathcal{N}(0, 1)$ est indépendant de $\epsilon_{\text{KO}}$ et $\epsilon_{\text{PEP}}$.
Visualisation du retour à la moyenne :
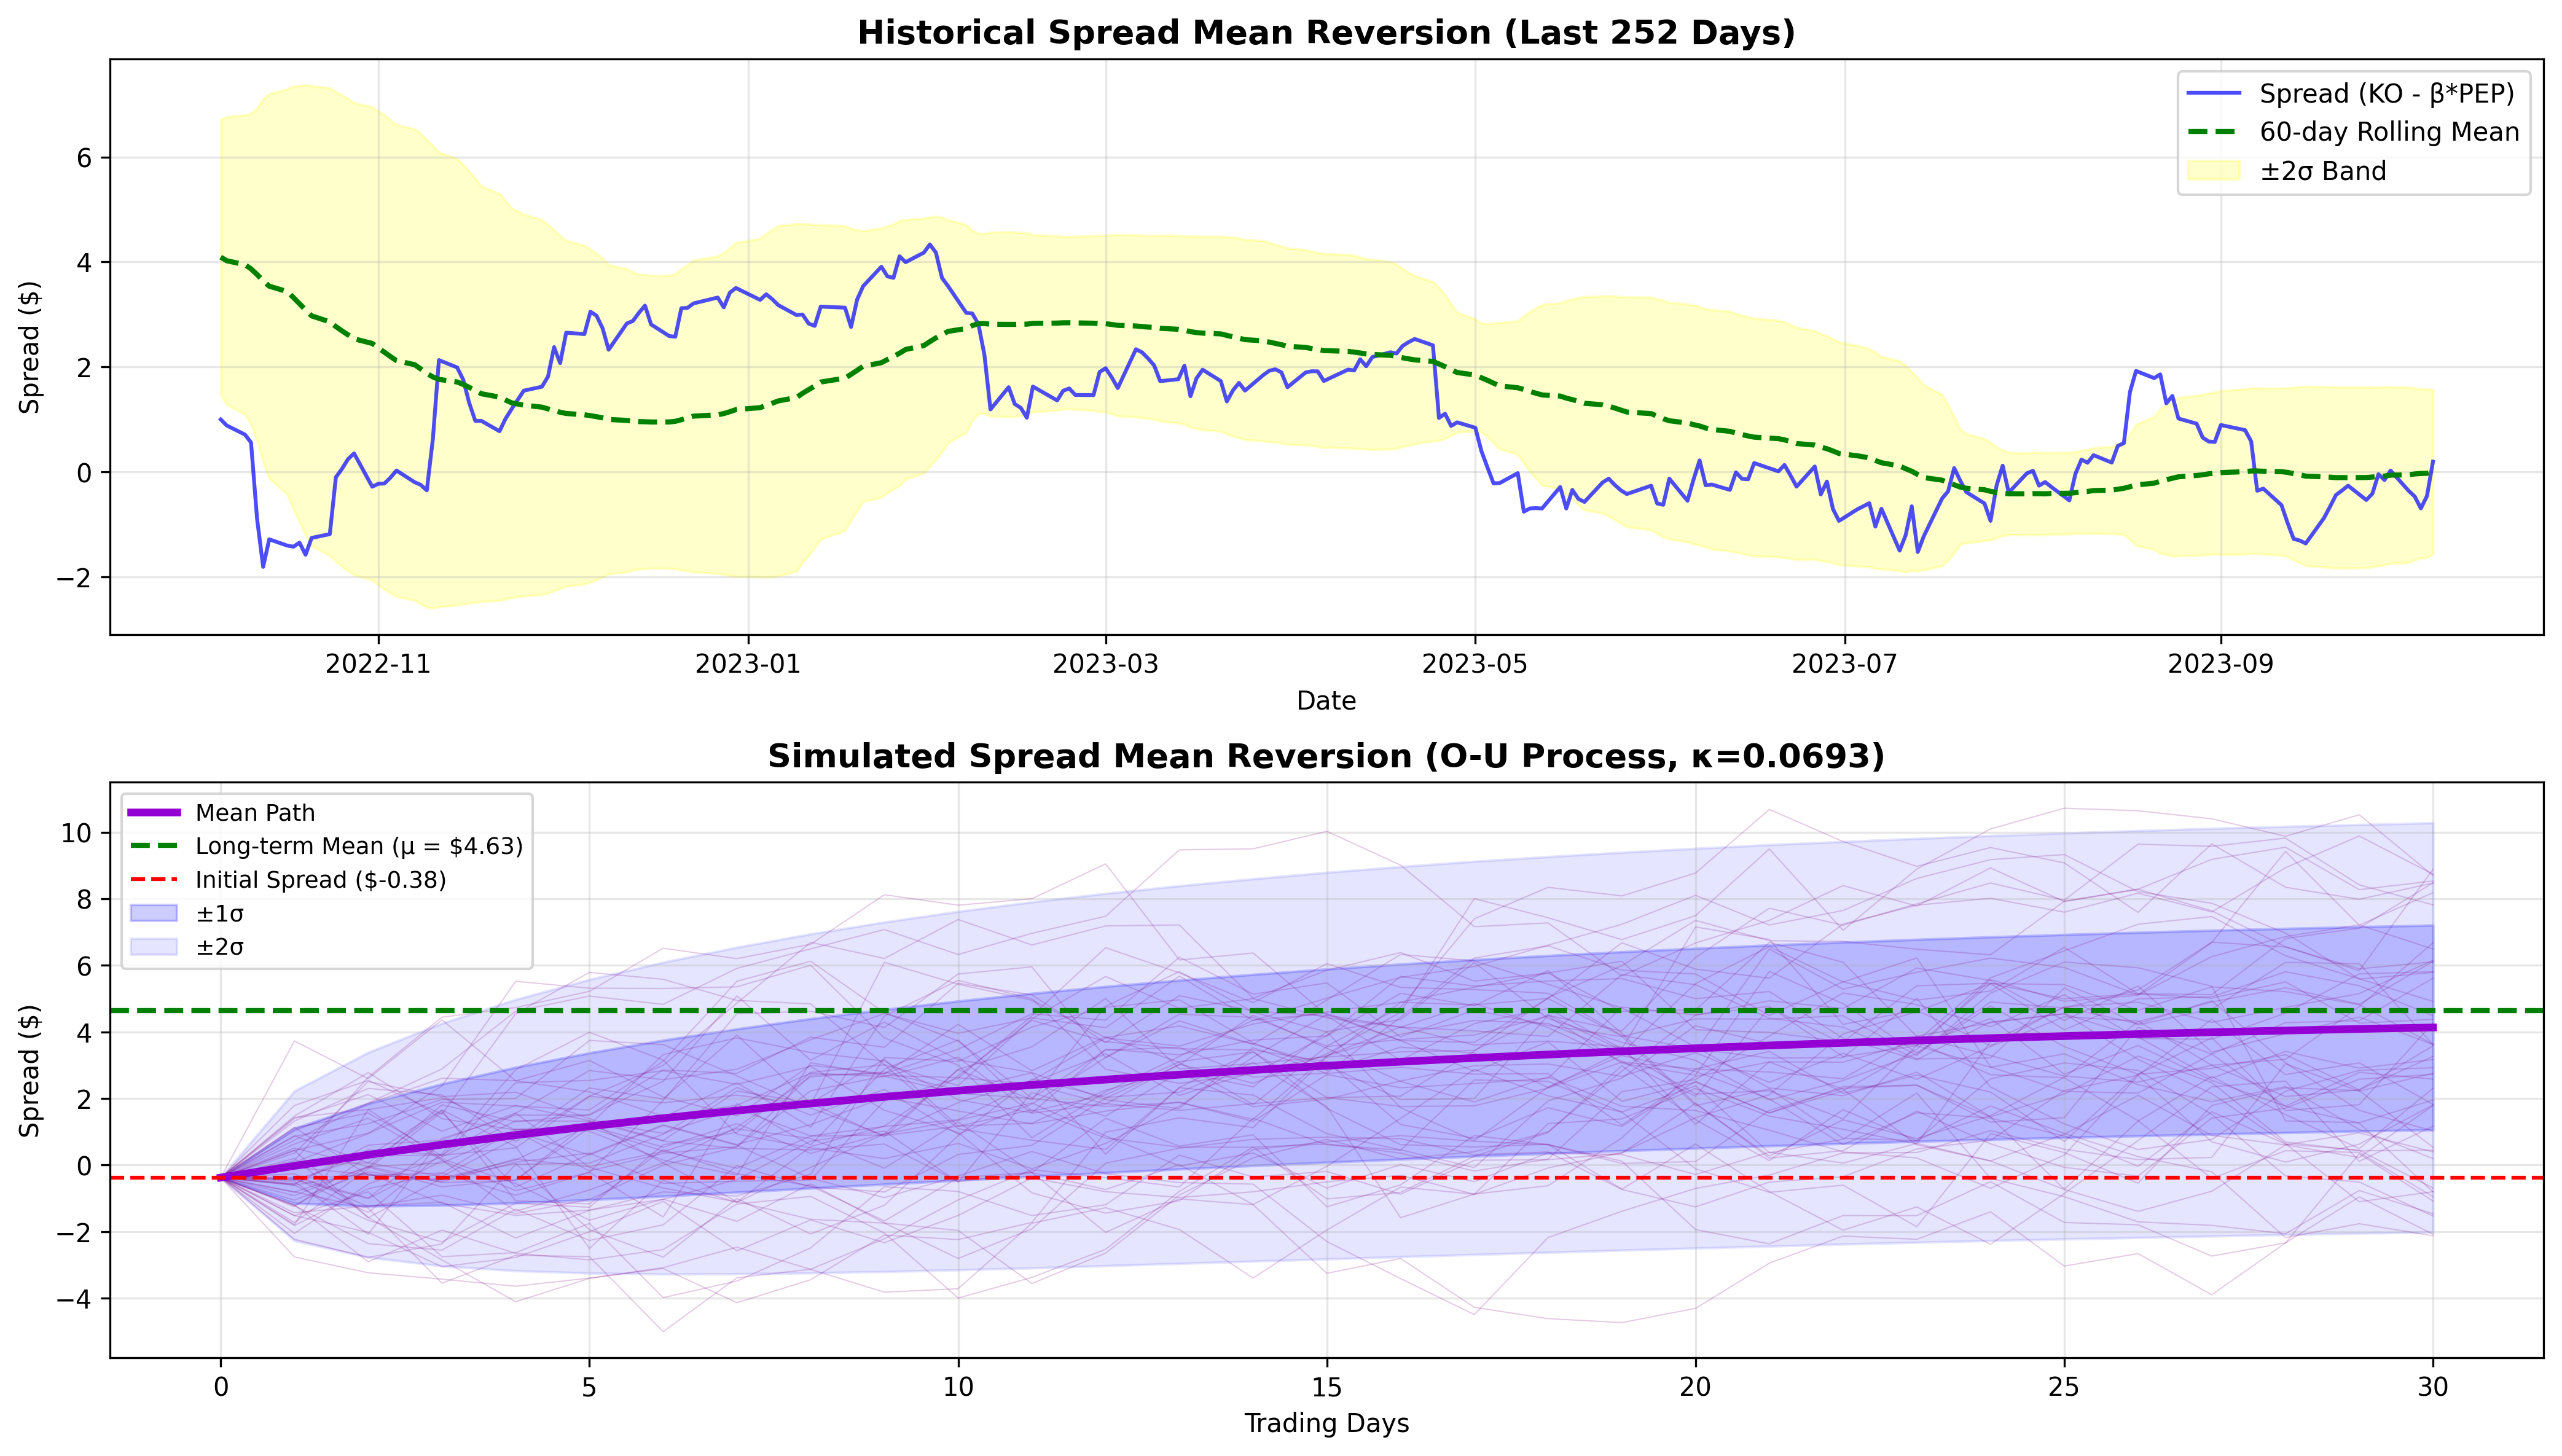
Les trajectoires simulées de l’écart se rapprochent de $\mu = 4.63$ à partir de la valeur initiale de $-\$0.38$. C’est le comportement que le terme O-U doit produire.
Répartir l’ajustement O-U
Je dois encore répartir l’ajustement O-U entre KO et PEP sans casser la relation de couverture. J’utilise pour cela des poids fondés sur la variance.
La variation de l’écart est :
$$\Delta S_t = \Delta \text{KO}_t - \beta \cdot \Delta \text{PEP}_t$$Je veux des ajustements $\Delta \text{KO}_{ou}$ et $\Delta \text{PEP}_{ou}$ tels que :
$$\Delta \text{KO}_{ou} - \beta \cdot \Delta \text{PEP}_{ou} = \text{O-U adjustment}$$Un choix pratique est :
# Variance-based weights
weight_ko = 1 / (1 + beta**2)
weight_pep = beta / (1 + beta**2)
Pourquoi cela fonctionne :
$$\frac{1}{1+\beta^2} - \beta \cdot \left(-\frac{\beta}{1+\beta^2}\right) = \frac{1 + \beta^2}{1+\beta^2} = 1$$Résultats avec $\beta = 0.333$ :
- $\text{weight\_ko} = 0.9002$ (90,0 % de l’ajustement va à KO)
- $\text{weight\_pep} = 0.2998$ (30,0 % de l’ajustement va à PEP, en sens opposé)
Implémentation complète
La boucle complète combine les cours GBM, les chocs corrélés par Cholesky et le retour à la moyenne O-U.
for day in range(n_days):
    # Generate random shocks: 2 correlated + 1 independent
    z = np.random.standard_normal((n_paths, 3))
    corr_z = z[:, :2] @ cholesky.T

    # GBM evolution with Itô correction
    ko_return = (ko_mean - 0.5 * ko_std**2) * dt + ko_std * np.sqrt(dt) * corr_z[:, 0]
    pep_return = (pep_mean - 0.5 * pep_std**2) * dt + pep_std * np.sqrt(dt) * corr_z[
        :, 1
    ]

    # O-U mean reversion adjustment
    current_spread = ko_prices[:, day] - beta * pep_prices[:, day]
    ou_drift = kappa * (spread_mean - current_spread) * dt
    ou_diffusion = spread_volatility * np.sqrt(dt) * z[:, 2]
    ou_adjustment = ou_drift + ou_diffusion

    # Distribute O-U force using variance-based weights
    ko_ou_return = (ou_adjustment * weight_ko) / ko_prices[:, day]
    pep_ou_return = -(ou_adjustment * weight_pep) / pep_prices[:, day]

    # Update prices
    ko_prices[:, day + 1] = ko_prices[:, day] * np.exp(ko_return + ko_ou_return)
    pep_prices[:, day + 1] = pep_prices[:, day] * np.exp(pep_return + pep_ou_return)
Résultats de la simulation
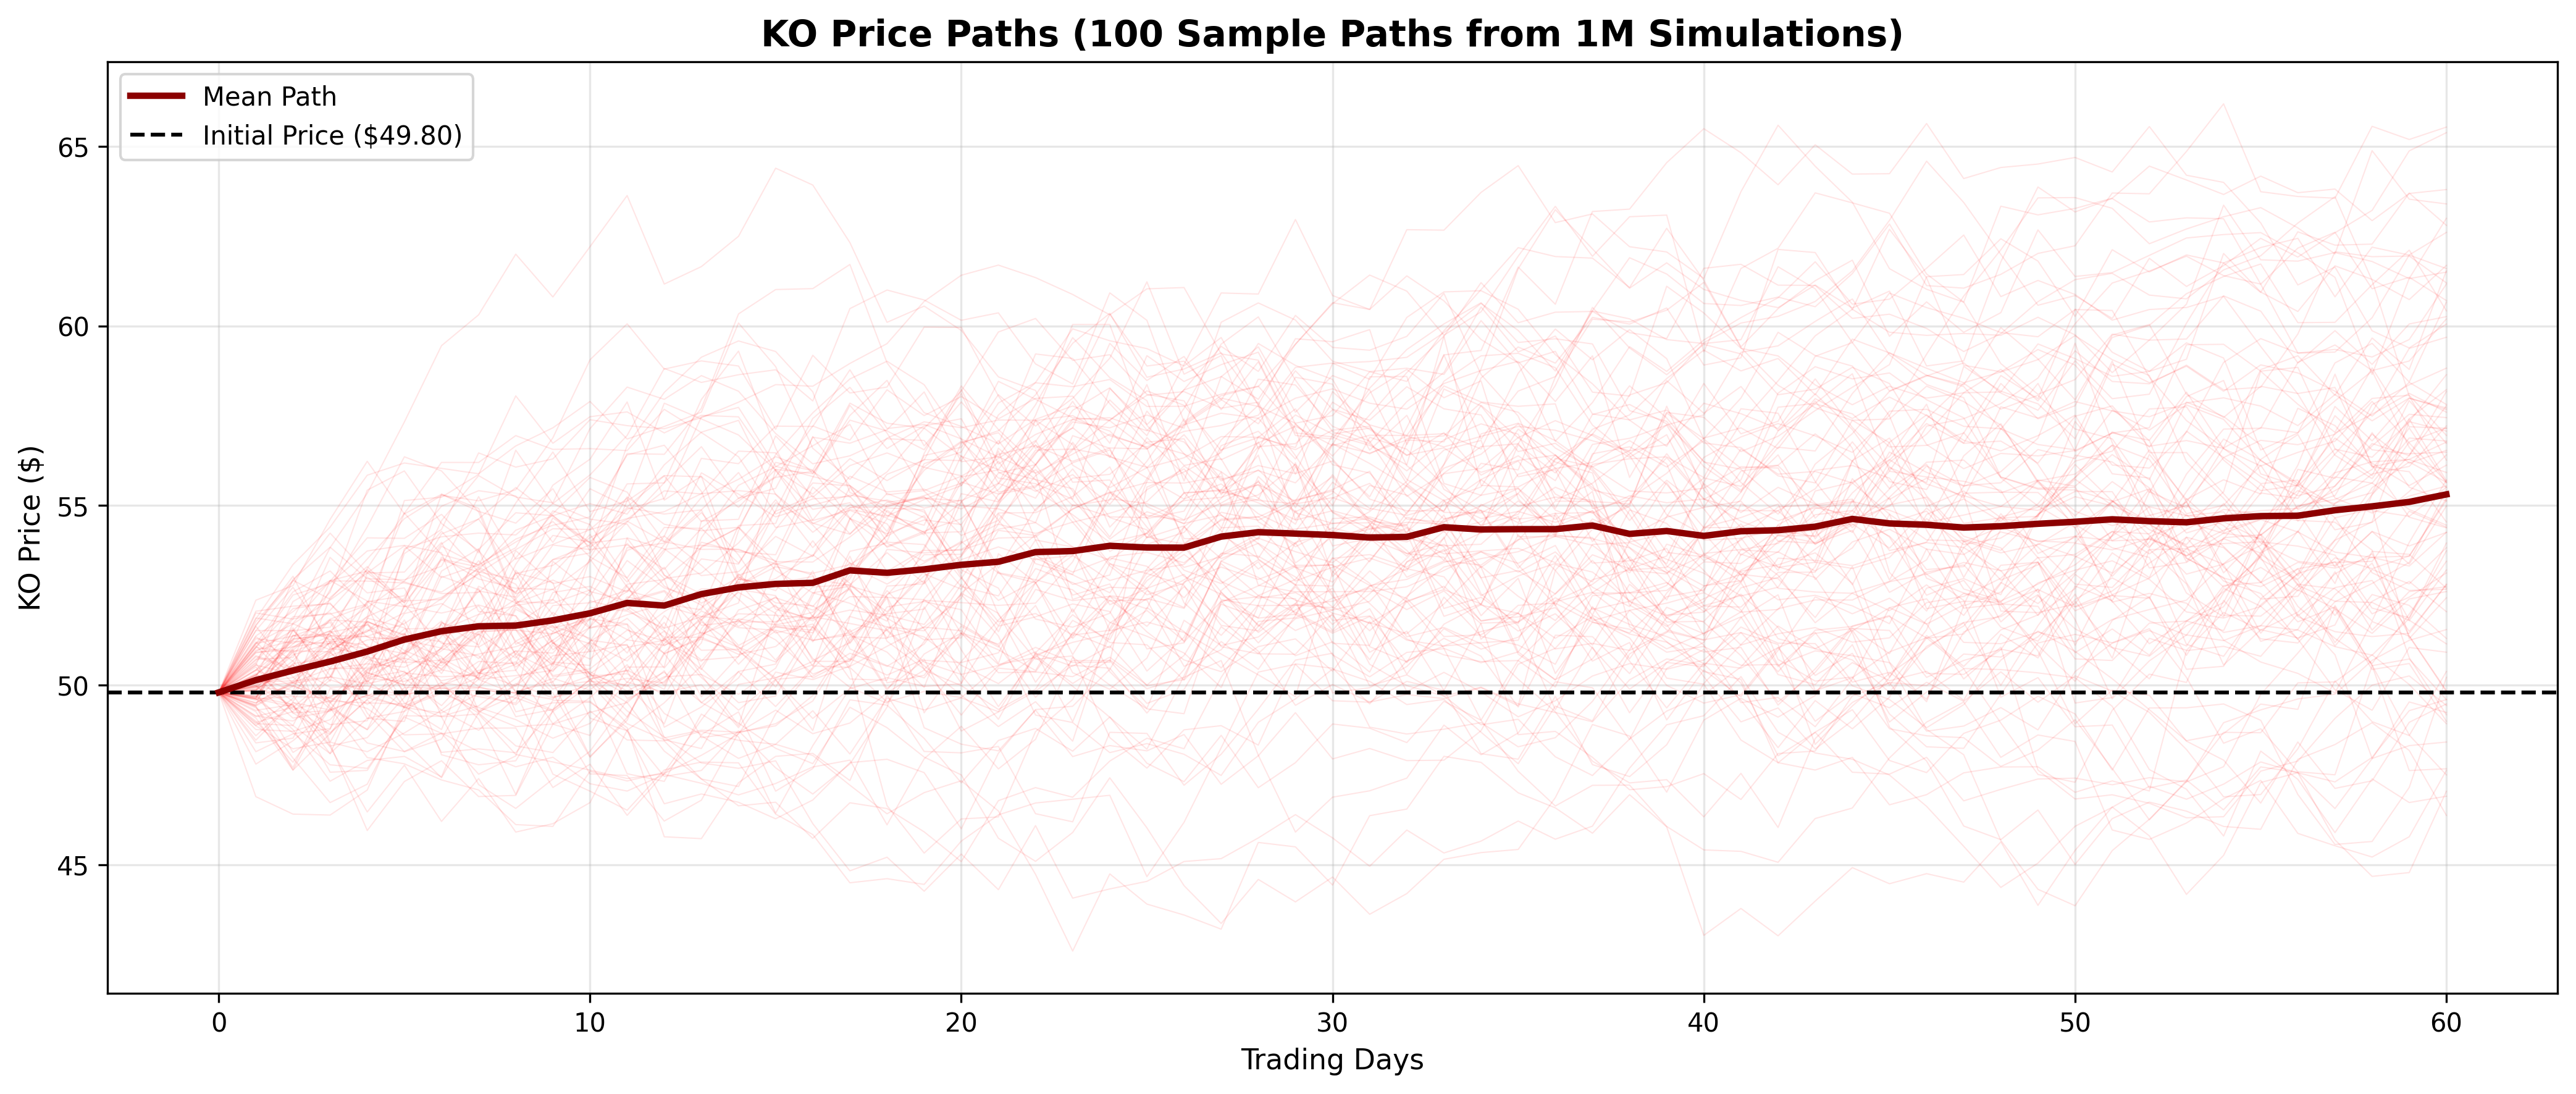
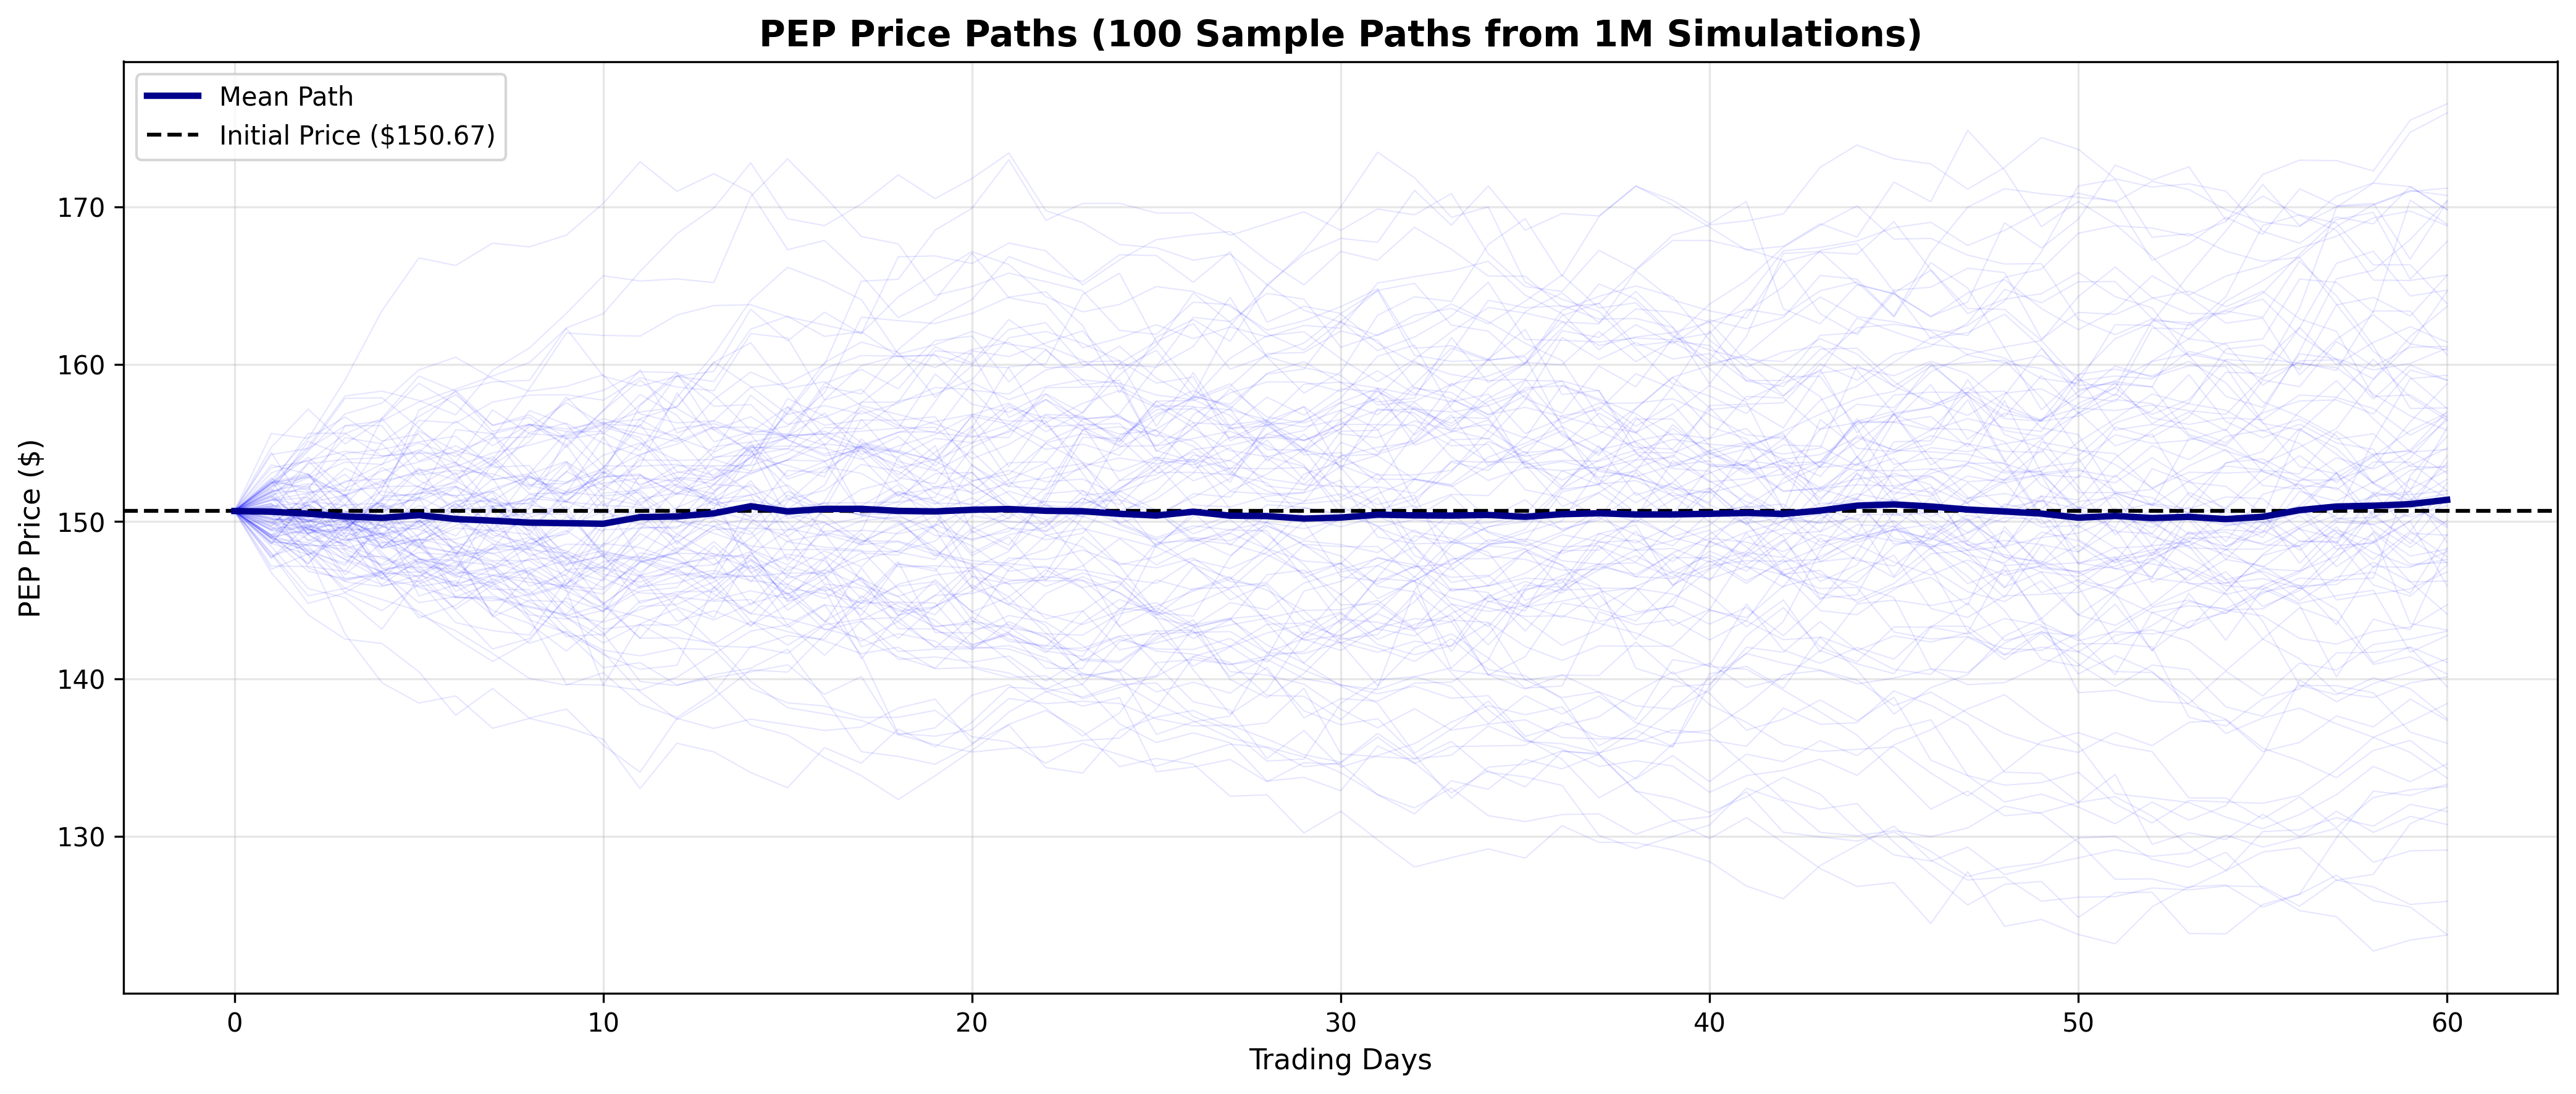
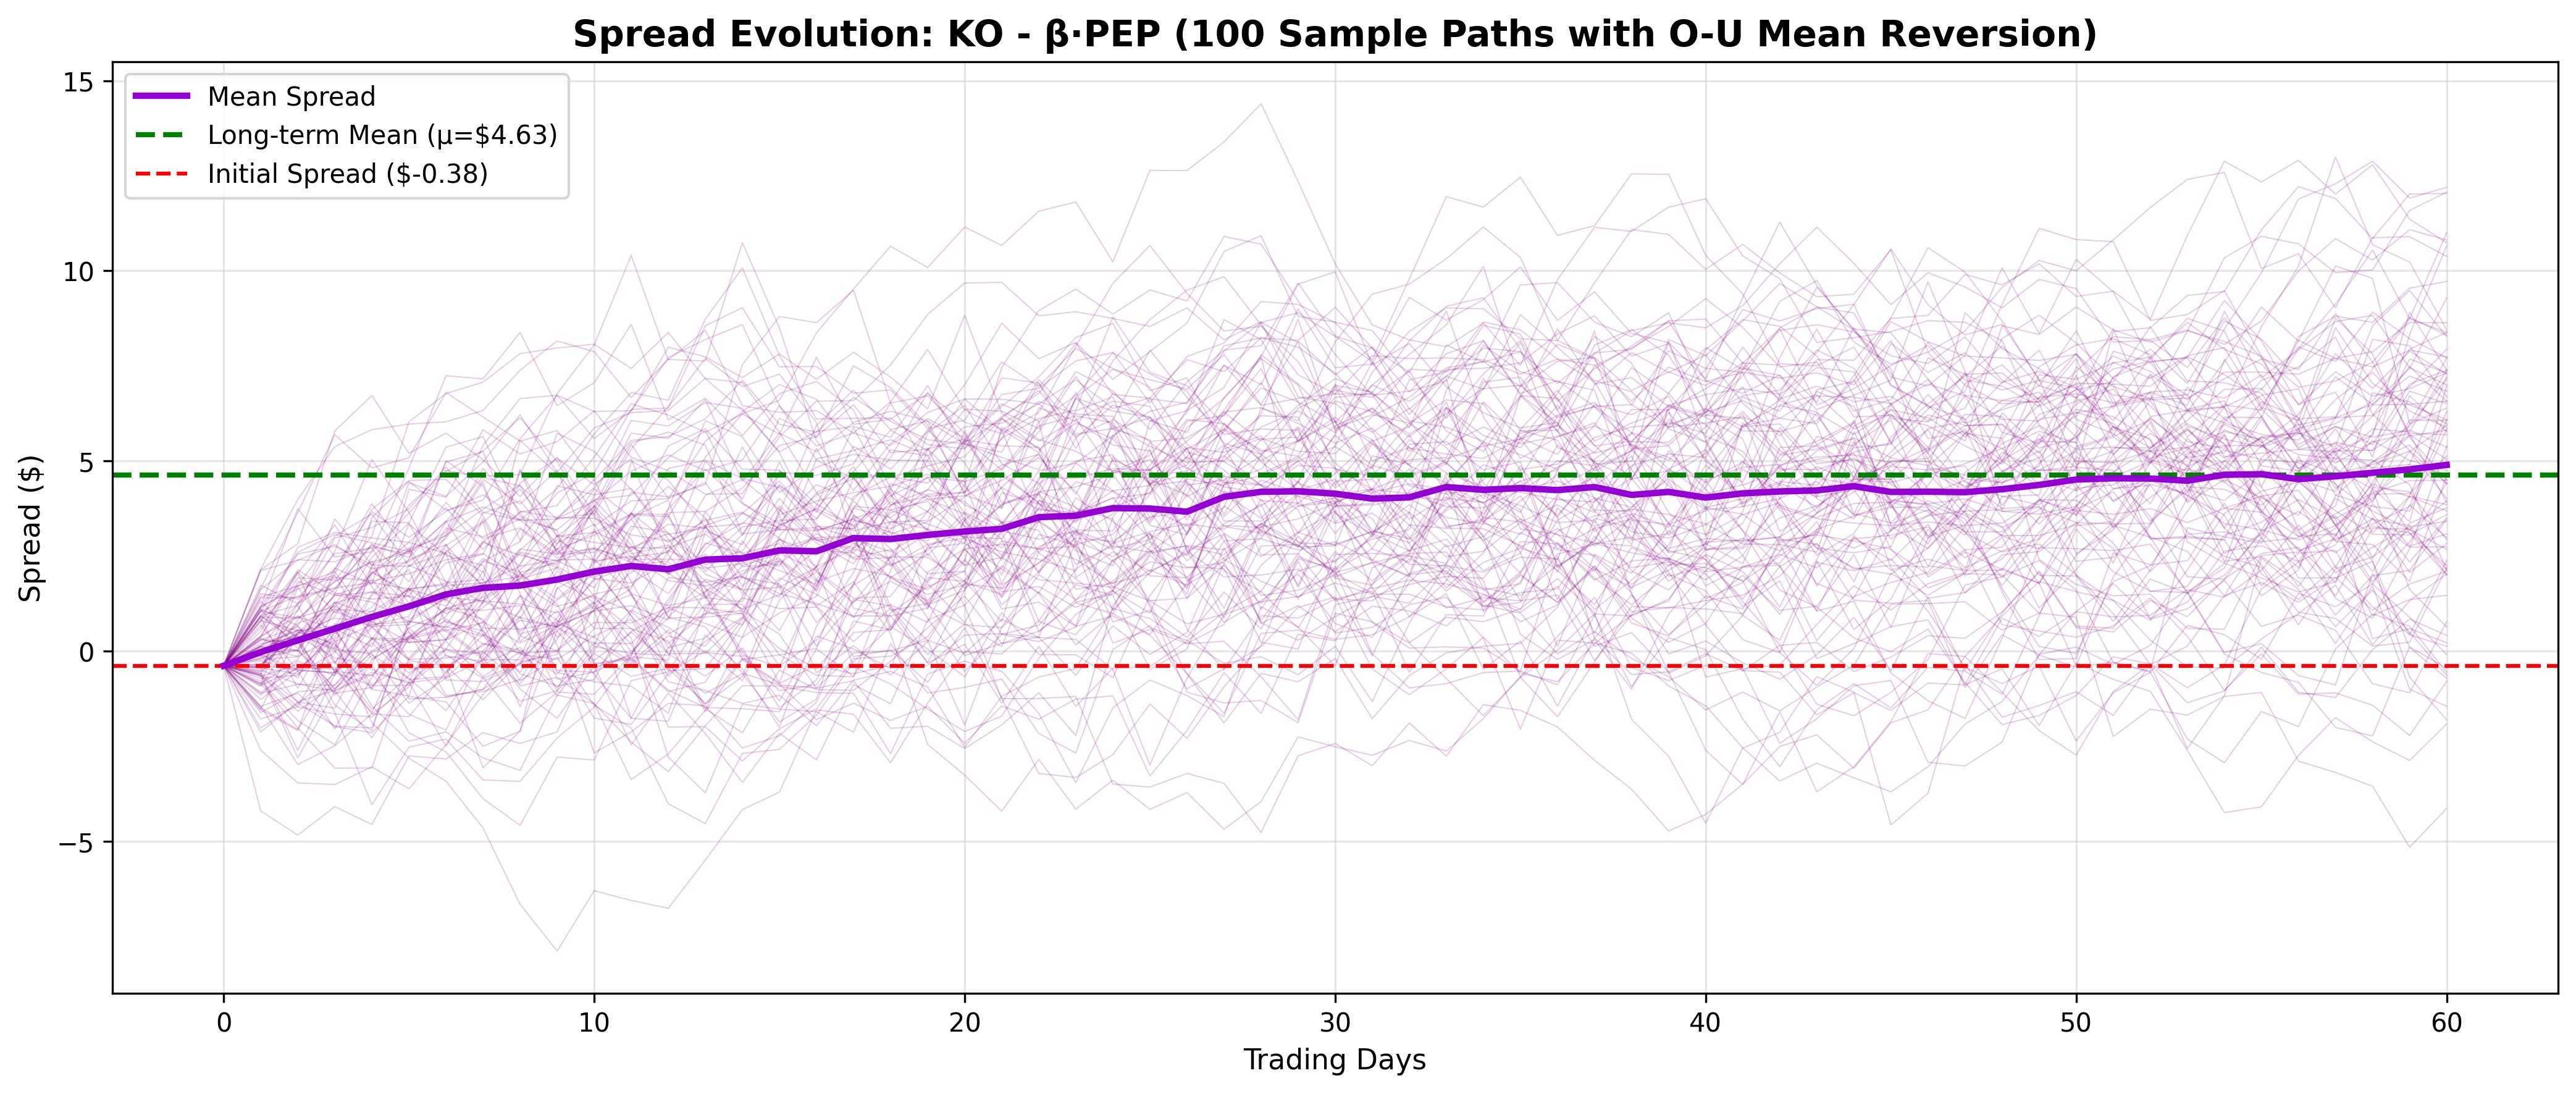
Les trois graphiques suivants montrent 100 trajectoires simulées :
Trajectoires de prix de KO :
Trajectoires de prix de PEP :
Évolution de l’écart :
Shane Gillis après la simulation
Après les trajectoires simulées, j’avais envie de finir sur quelque chose de moins technique :